

Демистификация на „черната кутия“: какво е токен, какво е тренировка, какво значи „предсказва следващата дума“ и защо това не е същото като мислене.
През 2024 г. изследователи от Anthropic усилиха изкуствено една отделна вътрешна настройка в езиковия си модел Claude. Резултатът беше странен: на въпроса „каква е физическата ти форма?“ моделът, който обикновено отговаря, че няма физическа форма, започна да твърди, че е мостът Голдън Гейт (при Сан Франсиско). Усилването на тази настройка направи модела вманиачен по моста и той го споменаваше в отговор на почти всеки въпрос, дори когато нямаше никаква връзка.
Този експеримент е добра отправна точка, защото показва две неща наведнъж. Вътре в езиковия модел има подреденост, която може да се намери и дори да се промени отвън. И едновременно с това поведението на модела не е магия, нито човешко мислене, а нещо трето, за което си струва да имаме точна представа.
Тук ще се опитаме да обясним как работи голям езиков модел (large language model, LLM) без математически формули. Целта е да придобиете интуиция, която ви пази едновременно от излишен страх и от прекомерно очарование от алгоритмите. За да стане ясно, ще разделим три неща, които често се смесват: от какво е построен моделът, как се обучава и какво прави, когато му пишете.
Какво всъщност влиза в модела
Първата заблуда, която трябва да изоставите, е, че моделът чете думи така, както ги четете вие. Това не е така.
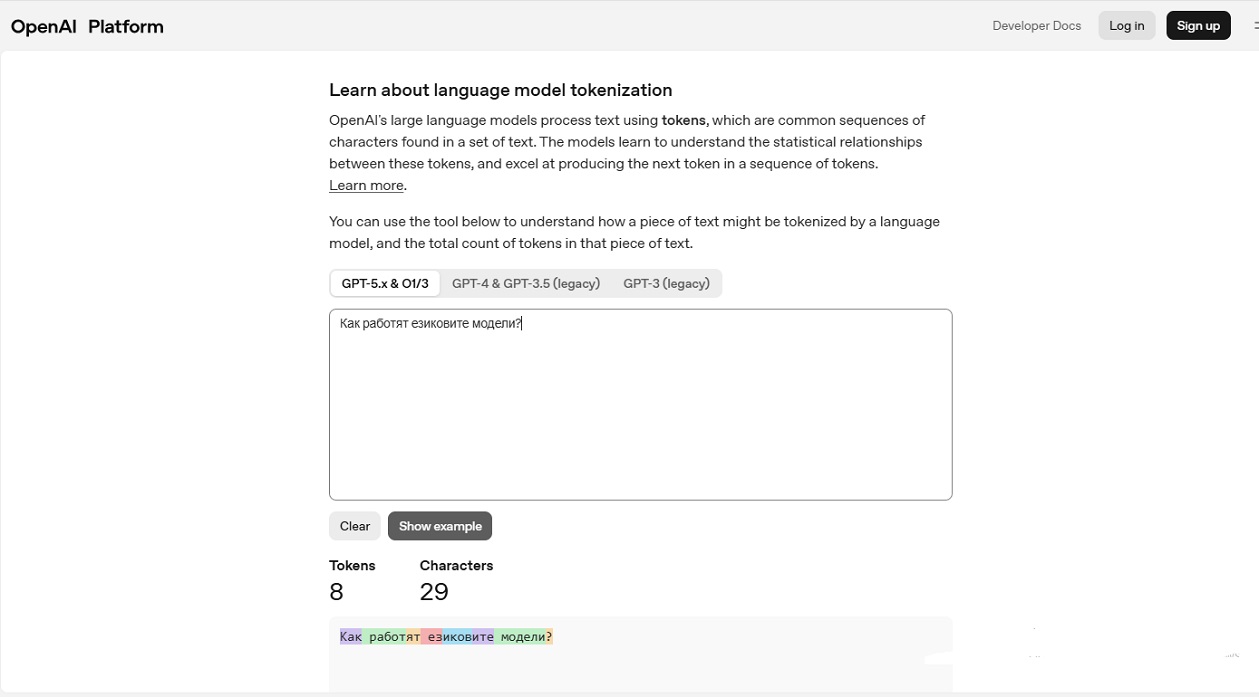
Преди да стигне до модела, текстът се нарязва на парчета, наречени токени. Токенът е единица текстова обработка, която може да съвпада с цяла дума, но често е част от дума, наставка, интервал или пунктуационен знак. Думата „непредвидимо“ например може да се раздели на няколко токена, а честа кратка дума като „и“ обикновено е един токен.
Можете да видите това и сами, като на страницата OpenAI Tokenizer напишете изречение, след което инструментът показва на колко токена се разпада то и къде минават границите. Бързо се забелязва, че границите не съвпадат с думите и че един и същ текст на различни езици дава различен брой токени.
Защо това има значение? Защото моделът не „вижда“ изречения, а получава поредица от дискретни парчета, всяко от които му е известно като число от речник. Когато по-нататък казваме, че моделът обработва или предсказва, винаги става дума за тези токени, не за думи в човешкия смисъл. Затова разпространеното обяснение, че „моделът работи с думи“, е полезно опростяване, но не е съвсем вярно.
Какво прави архитектурата
Токените влизат в архитектура, наречена трансформър. Тя идва от научна статия от 2017 г. със заглавие „Attention Is All You Need“ и оттогава стои в основата на почти всички съвременни езикови модели.
Без да влизаме във формулите, ето кое е същественото. Трансформърът обработва цялата поредица токени наведнъж и за всеки токен преценява кои други токени в текста са важни за него. Механизмът, който прави това претегляне, се нарича внимание (attention). Благодарение на него думата „той“ в едно изречение може да се свърже с лицето, споменато няколко изречения по-рано.
Тук е важно да не се поддадем на думата „внимание“. Тя е технически термин, а не описание на съзнателно усилие. Моделът не насочва внимание така, както го прави човек, който се съсредоточава. Названието описва математическа операция за претегляне на връзки между токени, нищо повече.
Резултатът от тази обработка е, че всеки токен се представя вътре в модела не като изолиран символ, а заедно с контекста около него. Същата поредица букви означава различно нещо в „река Места“ и в „места за паркиране“, и трансформърът е устроен така, че да улавя тази разлика.
Какво значи „тренировка“
Архитектурата сама по себе си не знае нищо. Знанието, ако може така да се нарече, идва от обучението.
Основният етап се нарича предварително обучение (pretraining). По време на него моделът минава през огромни количества текст и единствената му задача е проста за описване: като вижда част от текст, да предскаже кой е следващият токен. В началото предсказанията му са случайни. Всеки път, когато сбърка, вътрешните му настройки, наричани параметри, се коригират мъничко така, че следващия път да сгреши по-малко.
Параметрите са броят на тези регулируеми настройки и при големите модели те са десетки и стотици милиарди. Никой не ги задава ръчно. Те се нагласят автоматично в хода на обучението, така че моделът постепенно да става по-добър в предсказването на следващия токен в дадения контекст.
Полезно е да се каже и какво не е това обучение. То не е запаметяване на енциклопедия и не е презаписване на интернет вътре в модела. По-точно е да се мисли за статистическо научаване на закономерности: кои поредици от токени се срещат заедно, какви структури имат изреченията, какви стилове и зависимости са чести. Затова моделът може да продължи текст по правдоподобен начин, без да притежава копие на оригиналните източници.
И още нещо за честността: фактите, които моделът „знае“, не лежат на едно място, като ред в база данни. Изследванията показват, че всяко понятие е представено в много неврони, и всеки неврон участва в представянето на много понятия. Знанието не стои подредено на едно място като в склад, а е разпръснато из цялата мрежа.
Какво значи „предсказва следващата дума“
Стигаме до фразата, която чувате най-често и която най-лесно се разбира погрешно. Когато напишете нещо на модела, той не съчинява целия отговор наведнъж. Работи токен по токен. Поглежда целия текст дотук, изчислява кой следващ токен е най-вероятен в този контекст, избира един, добавя го към текста и повтаря. Всеки нов токен става част от входа за следващата стъпка. Така всяко изречение се гради постъпково, парче по парче.
Това обяснява няколко неща, които иначе изглеждат загадъчни. Обяснява защо моделът понякога звучи уверено, а греши: вероятното продължение не е същото като вярното продължение. Обяснява и защо два пъти един и същ въпрос може да даде различни отговори, тъй като изборът на следващ токен обикновено включва малко контролирана случайност.
Тук трябва да се пазим от втората крайност. От това, че моделът предсказва по една стъпка, не следва, че е просто „автоматично довършване на думи“. Между входа и предсказването стоят милиарди настройки и многопластова обработка, която улавя сложни зависимости в текста. Поведението, което излиза от тази проста на пръв поглед задача, може да бъде изненадващо богато. Затова и двете опростявания, „магия“ и „просто автоматично довършване“, водят доста встрани от процедирането на този механизъм.
Защо това не е същото като мислене
Сега вече можем да отговорим на основния въпрос направо, без да омаловажаваме и без да преувеличаваме. Моделът е настроен да продължава текст по вероятен начин. Когато решава задача стъпка по стъпка или обяснява разсъждение, той генерира текст, който прилича на разсъждение, защото такива текстове е виждал много по време на обучението си. Това, че изходът изглежда като мислене, не е доказателство, че вътре протича човешки тип разбиране, намерение или самосъзнание.
Внимавайте обаче и с обратната грешка. Да кажем „това е просто статистика“ също не върши работа, защото подценява факта, че вътре в модела наистина има структура, която отговаря на смислени понятия. Истината е по-интересна от двата лозунга: има вътрешни представяния, те имат подреденост, но тази подреденост не съвпада просто с интуитивната ни представа за „мисъл“.
Полезно е да се пази и едно разграничение от психологията на хората. Когато човек твърди нещо уверено, обикновено има усещане дали знае, или гадае. Езиковият модел няма такъв вътрешен сигнал за собствената си надеждност, заложен в начина, по който работи. Той произвежда най-вероятното продължение, независимо дали то е добре обосновано, или не. Това е и една от причините за така наречените халюцинации, при които моделът изрича уверено невярна информация.
Какво показват изследванията за черната кутия
Изразът „черна кутия“ описва реално положение, а не мистика. Вътрешното състояние на модела, преди да напише отговора си, представлява дълъг списък от числа без ясно значение, и не е очевидно защо моделът е дал точно този отговор, а не друг. Тоест дори да отворим кутията и да погледнем числата вътре, те сами по себе си не ни казват нищо.
Това обаче започва бавно да се променя. Anthropic публикуват изследване, в което съобщават, че са успели да намерят как милиони понятия са представени вътре в техния модел Claude. Това е първият подробен поглед навътре в съвременен, реално работещ голям езиков модел.
Как го правят? Вместо да гледат отделните неврони, които са объркващи, изследователите търсят повтарящи се модели на активност, наречени характеристики (features). Откриват характеристики, които отговарят на конкретни неща като градове, хора, химични елементи, научни области и програмен синтаксис. Любопитното е, че тези характеристики не зависят от езика или формата. Една и съща характеристика за моста Голдън Гейт се задейства от споменаване на името на английски, от обсъждане на японски, китайски, гръцки, виетнамски и руски, както и от изображение на моста.
Намерената подреденост донякъде съвпада с човешката. Близо до характеристика, свързана с понятието „вътрешен конфликт“, се откриват характеристики за раздели във връзки, противоречиви лоялности и логически несъответствия. Тоест начинът, по който моделът вътрешно групира понятията, поне отчасти отговаря на нашите представи за сходство.
Най-силното доказателство, че тези характеристики наистина участват в поведението, е, че те могат да се променят. Когато изследователите усилиха характеристиката за моста, моделът наистина се промени, точно както описахме в началото. Това, че промяната на характеристиката води до съответна промяна в поведението, потвърждава, че характеристиките не са просто свързани с понятията, а реално оформят начина, по който работи моделът.
И тук идва най-откровената част от изследването, която ни пази от прекалено очарование. Намерените характеристики са малка част от всички понятия, които моделът усвоява по време на обучението, а намирането на пълния набор с днешните методи би било непосилно скъпо. Освен това има още една празнина – това, че разбираме кои представяния използва моделът, не ни казва как той ги използва. Имаме характеристиките, но все още не сме открили веригите, в които те участват. С прости думи, започнахме да четем речника на модела, но още не разбираме изреченията му.
Какво да вземете със себе си
Една устойчива интуиция за това как работи езиков модел може да се събере в няколко изречения. Текстът се нарязва на токени. Трансформърът ги обработва, като преценява кои са важни един за друг. По време на обучението моделът се настройва да предсказва следващия токен въз основата на огромни масиви текст. А когато му пишете, той гради отговора токен по токен, избирайки вероятното продължение.
От това следва спокоен начин да го осмислите. Моделът не разбира текста като човек, но и не е просто фокус с думи. Той е система с реална вътрешна структура, която произвежда правдоподобен текст и понякога греши уверено. Това обяснява защо е полезен за чернови, обобщения и идеи, и едновременно защо не бива да разчитате на него за факти без проверка.
Изследванията върху черната кутия вървят в обнадеждаваща посока, но са в ранен етап. Вече можем да надникнем вътре и да намерим смислени понятия, но все още не можем да проследим целия път от началото до отговора. Дотогава най-доброто, което можете да направите, е да използвате тези модели като силен, но погрешим инструмент, а не като оракул, нито като заплаха.
Често задавани въпроси
Моделът „знае“ ли, че греши, когато халюцинира? Не по начина, по който човек усеща, че гадае. Моделът произвежда най-вероятното продължение и няма вграден сигнал, който да отделя добре обоснованото от неоснователното. Затова увереният му тон не е гаранция за вярност.
Токен и дума едно и също ли са? Не. Токенът може да е цяла дума, но често е част от дума, наставка, интервал или пунктуация. Един и същ текст на различни езици се разпада на различен брой токени.
Когато моделът „разсъждава“ на стъпки, наистина ли мисли? Той произвежда текст, който прилича на разсъждение, защото е виждал много такива текстове. Сходството с разсъждение не доказва човешки тип разбиране или намерение.
Може ли изобщо да се погледне вътре в модела? Да, отчасти. Изследователи вече намират вътрешни характеристики, които отговарят на конкретни понятия, и дори ги променят. Но това е малка част от пълната картина и не обяснява как точно моделът стига от задаването на въпроса до отговора.
Основни източници:
- Vaswani et al., „Attention Is All You Need“ (arXiv, 2017): https://arxiv.org/abs/1706.03762
- OpenAI Tokenizer https://platform.openai.com/tokenizer
- Anthropic, „Mapping the Mind of a Large Language Model“ (2024) – https://www.anthropic.com/research/mapping-mind-language-model
- Stanford CS336, „Language Modeling from Scratch“ – https://cs336.stanford.edu/
- 3Blue1Brown – https://www.3blue1brown.com/lessons/mini-llm
- Бележки по Stanford CS336 (Dhyey Mavani): https://dhyeymavani.com/teaching/stanford-cs336-language-modeling-from-scratch/
Автор: Радослав Тодоров
Изображения: canva.com, platform.openai.com/tokenizer
Още подобни материали четете в новия специални брой на списание „Българска Наука“


