

Нова изчислителна платформа позволява на учените да търсят обещаващи молекули за бъдещи лекарства в библиотеки с десетки милиарди съединения. Разработката, наречена AdaptiveFlow, използва машинно обучение и облачни изчисления, за да намали значително необходимите изчислителни ресурси и да превърне задачи, отнемащи месеци, в изчисления, които при подходяща инфраструктура могат да бъдат извършени за часове.
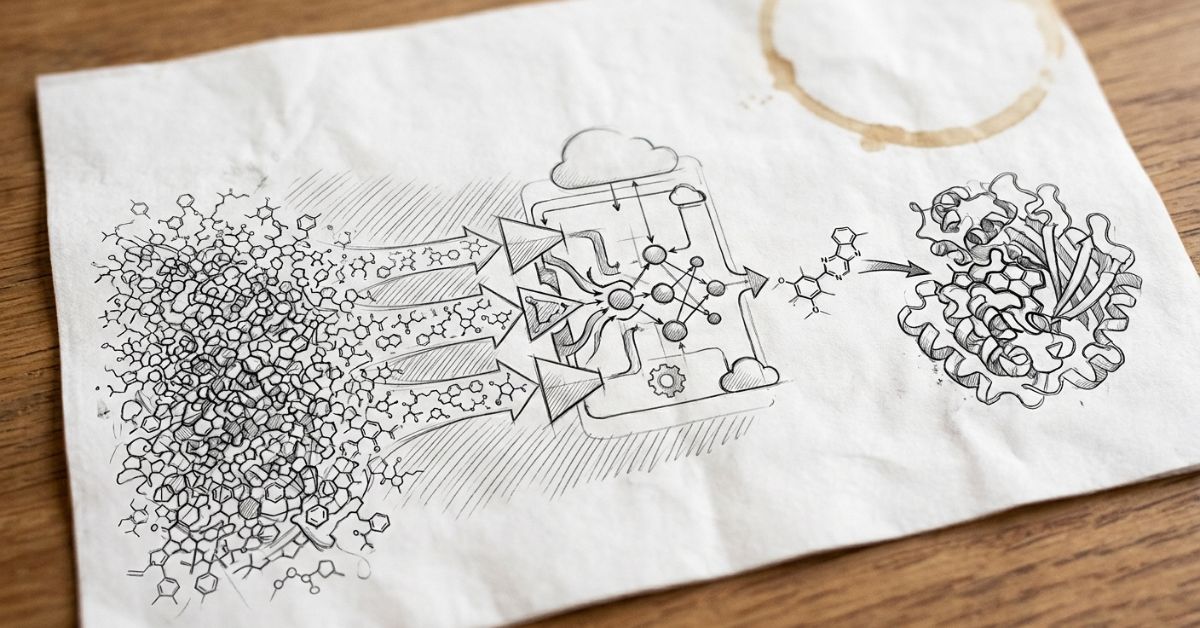
Откриването на ново лекарство често започва с нещо, което напомня търсене на игла в купа сено. Учените разполагат с огромен брой химични молекули, но само малка част от тях могат да се свържат по подходящ начин с определен белтък в човешкото тяло и евентуално да повлияят на заболяване.
С увеличаването на химичните библиотеки проблемът става още по-сериозен. Днес те могат да съдържат милиарди потенциални молекули. Подробното изчислително изследване на всяка от тях изисква огромни ресурси.
Екип от учени от Детската изследователска болница „Сейнт Джуд“, Университета в Павия, Института за ракови изследвания „Дейна-Фарбър“, Медицинското училище на Харвард и други научни организации предлага решение на този проблем.
Новата им платформа AdaptiveFlow е представена на 1 септември 2026 г. в списание Nature Biotechnology.
Според изследователите системата може да работи с библиотека от 69 милиарда молекули, подготвени за виртуално изследване, като намалява необходимите изчислителни ресурси приблизително 1000 пъти в сравнение със съществуващи подходи.
Как компютърът „изпитва“ милиарди молекули
В ранните етапи на разработването на лекарства учените могат да използват т.нар. виртуално пресяване. Вместо всяко химично вещество веднага да бъде синтезирано и изпитано в лаборатория, компютърни програми оценяват кои молекули имат най-голям шанс да взаимодействат с определена биологична мишена.
Тази мишена обикновено е белтък, свързан с развитието на дадено заболяване.
Компютърът изследва как различни молекули биха могли да се разположат в определен участък на белтъка и оценява доколко силно биха се свързали с него. Едва най-обещаващите кандидати преминават към последващи лабораторни изпитвания.
Подобен подход може да спести огромно количество време и средства. Трудността е, че когато вместо няколко милиона трябва да бъдат разгледани десетки милиарди молекули, дори компютърното пресяване се превръща в изключително тежка задача.
Точно тук се намесва AdaptiveFlow.
Вместо да проверява всичко с еднаква подробност
Една от важните особености на системата е, че тя не третира всички милиарди молекули по един и същи начин от самото начало.
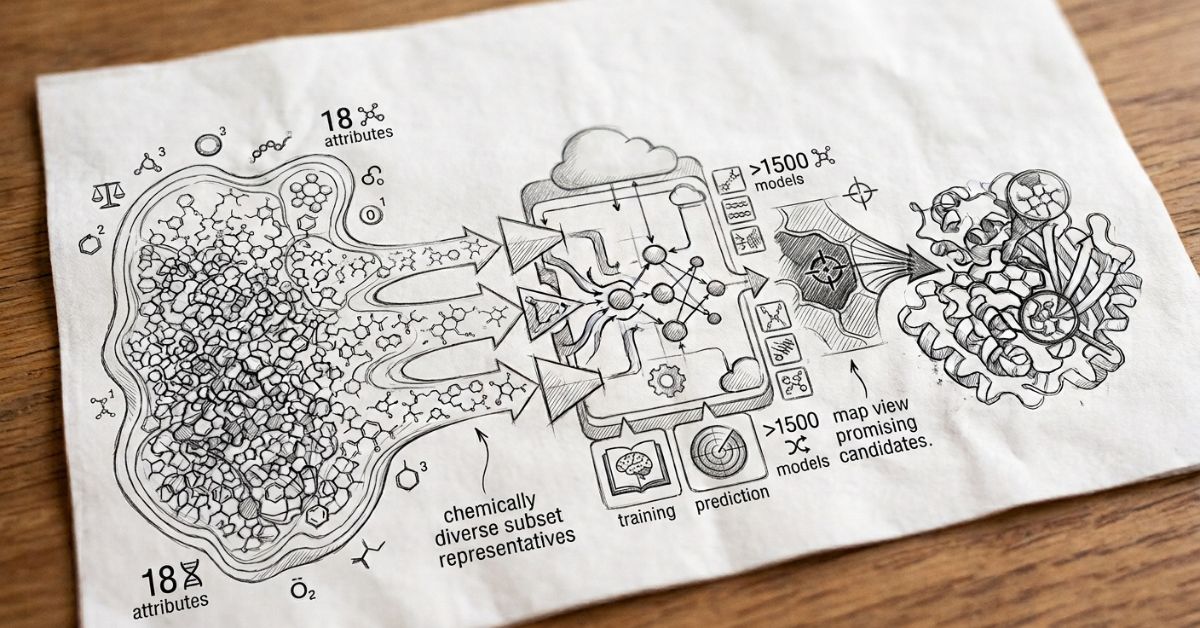
AdaptiveFlow организира веществата според 18 различни молекулни характеристики. Сред тях например е молекулната маса. Така огромната химична библиотека може да бъде разглеждана като многомерна карта, върху която се виждат различните типове молекули.
От тази карта системата първоначално подбира химически разнообразни представители.
Резултатите от предварителното им изследване след това се използват за обучение на модел за машинно обучение. Неговата задача е да разпознае в кои области на огромното химично пространство се намират най-перспективните кандидати.
Едва след това усилията се насочват към най-обещаващите молекули, които се изследват по-подробно спрямо избрания белтък.
Платформата поддържа над 1500 различни начина за изчислително моделиране на взаимодействието между молекула и белтъчна мишена.
Така изчислителната мощ се насочва там, където вероятността да бъдат открити интересни съединения е най-голяма.
До 5,6 милиона виртуални процесора
Другото съществено постижение на AdaptiveFlow е начинът, по който платформата използва облачни изчислителни системи.
При много програми добавянето на все повече процесори в един момент престава да води до съответно ускоряване. Част от времето започва да се губи в обмен на данни и координиране на отделните задачи.
При изпитванията на AdaptiveFlow учените съобщават за практически линейно увеличаване на производителността до 5,6 милиона виртуални процесорни единици.
Казано по-просто: когато към задачата се добавят повече изчислителни ресурси, системата успява ефективно да ги използва, вместо голяма част от допълнителната мощ да се губи.
Това е особено важно при търсенето сред библиотеки от милиарди молекули, където мащабът на изчисленията е огромен.
Изпитание срещу две мишени, свързани с рака
За да покажат, че платформата може да бъде използвана не само като изчислителен експеримент, учените я прилагат към две белтъчни мишени, свързани с онкологични заболявания.
Първата е PARP1 — добре проучен белтък, срещу който вече съществуват одобрени противоракови лекарства. Това го прави подходяща отправна точка за оценка на новия метод.
Втората мишена е FSP1 — белтък, който участва в механизмите, чрез които клетките могат да се предпазват от определен вид клетъчна смърт, известна като фероптоза. През последните години FSP1 привлича внимание и заради ролята си в оцеляването на някои ракови клетки.
Тази мишена е по-трудна за изследване, включително заради особеностите на мястото, към което трябва да се свърже потенциалният лекарствен кандидат.
AdaptiveFlow успява да открие инхибитори и за двете мишени. Според авторите някои от намерените съединения показват сила на свързване, сравнима с тази на молекули с фармацевтично значение.
Именно резултатите при FSP1 са особено интересни, тъй като показват, че методът може да бъде полезен и при по-сложни биологични мишени.
Това все още не означава ново лекарство
Въпреки впечатляващия мащаб, важно е резултатът да бъде поставен в правилния контекст.
AdaptiveFlow не превръща автоматично намерената молекула в лекарство.
Виртуалното пресяване е един от най-ранните етапи в дългия процес на разработване на медикаменти. След откриването на обещаващо съединение то трябва да бъде синтезирано и проверено експериментално. Следват изследвания на неговата активност, токсичност, устойчивост в организма, възможни странични действия и множество други свойства.
Едва след успешни предклинични изследвания може да се стигне до клинични изпитвания при хора.
Следователно голямото предимство на платформата е друго: тя може да помогне на изследователите много по-бързо да изберат откъде си струва да започнат лабораторната работа.
При десетки милиарди възможни съединения по-добрият първоначален подбор може да бъде решаващ.
Отворена система, достъпна и за други изследователи
Разработчиците са публикували AdaptiveFlow като платформа с отворен програмен код. Предоставени са инструкции и ръководства за използването ѝ, а програмата може да бъде изтеглена свободно.
Това е важно, защото изследването на огромни химични библиотеки досега до голяма степен беше възможно за организации, които разполагат със значителни изчислителни ресурси и специализирани екипи.
Намаляването на необходимите изчисления не премахва нуждата от мощна инфраструктура при най-мащабните задачи, но може да направи подобни методи достъпни за значително повече научни групи.
И именно това може да се окаже най-същественият резултат от работата.
Милиардите виртуални молекули сами по себе си не създават нови лекарства. Но ако учените могат по-бързо и по-евтино да откриват сред тях няколко действително обещаващи кандидата, времето между първоначалната научна идея и експерименталната проверка може чувствително да се съкрати.
А при заболявания, за които все още липсват достатъчно ефективни терапии, това е възможност, която си заслужава да бъде изследвана.
Научна публикация:
Domiziana Cecchini и съавт., AI-Enhanced Adaptive Virtual Screening Platform Enabling Exploration of 69 Billion Molecules Discovers Structurally Validated FSP1 Inhibitors, Nature Biotechnology, публикувана на 1 септември 2026 г.
https://www.nature.com/articles/s41587-026-03217-x
Платформа:
https://adaptive-flow.ai/
https://github.com/QuantumAI4Bio

