

Само преди няколко години най-мощните системи с изкуствен интелект можеха да бъдат създавани и управлявани от много малък брой технологични компании. Разработването на модел от най-висок клас изискваше огромни изчислителни ресурси, специализирани екипи, инфраструктура и инвестиции, които практически изключваха малкия и средния бизнес.
През 2026 г. ситуацията вече е различна.
Днес една компания може да изтегли готов AI модел с десетки милиарди параметри и да го използва на собствена работна станция или сървър. А при най-големите модели може да изгради собствена сървърна инфраструктура, без да трябва първо да инвестира стотици милиони в разработването и обучението на самия модел.
Примери за тази промяна са [Qwen3.8-27B] Qwen3.8-27B в Hugging Face и новият [Kimi K3] официалното представяне на Kimi K3.
Те са много различни като размер и изисквания към хардуера, но показват една и съща тенденция: изключително скъпо създадената AI технология все по-често се превръща в инфраструктура, която други компании могат да изтеглят, внедрят и адаптират към своя бизнес.
Това е важна промяна не само за AI индустрията, а и за икономиката на софтуера като цяло.

Колко струваше да се създаде модел като GPT-4?
Тук има важно уточнение.
Понякога се срещат твърдения, че GPT-4 е струвал милиарди долари. Това не е добра формулировка, ако говорим конкретно за обучението на самия модел.
В своя AI Index Stanford University оценява изчислителния ресурс за обучението на GPT-4 на приблизително 78 млн. долара. За Gemini Ultra оценката е около 191 млн. долара.
Stanford AI Index – Research and Development
Но това е оценка на изчислителния ресурс за основното обучение, а не пълната цена за създаването на една AI система.
Около него има години изследователска работа, заплати на специалисти, подготовка на данни, експериментални обучения, модели, които никога не стигат до потребителите, инфраструктура и огромни разходи за използването на готовите системи.
Точно тук вече се появяват милиардите.
Анализ на Epoch AI оценява, че през 2024 г. OpenAI е изразходвала около 5 млрд. долара за изчислителни ресурси, свързани с изследвания, експерименти и обучение. Според анализа около 4,5 млрд. долара от тях са били за други изследователски и експериментални натоварвания, а не за финалните тренировъчни серии на публикуваните модели. Това са оценки на Epoch AI, основани на публични данни и публикации, а не официално одитиран финансов отчет на OpenAI.
Epoch AI – Most of OpenAI’s 2024 compute went to experiments
И точно тук се вижда голямата промяна.
За една обикновена компания вече не е необходимо да плати цената за откриването и обучението на тази технология. Някой друг вече е направил огромната инвестиция.
Компанията може да започне от готовия модел.
Qwen3.8-27B: мощен модел, който вече може да бъде локален
Добър пример е Qwen3.8-27B.
Моделът има 27 млрд. параметъра и е публикуван с лиценз Apache 2.0. Той комбинира езиков модел с визуални възможности и може да работи с текст, изображения и видео. Има естествен контекст от 262 144 token, който може да бъде разширен до 1 милион token.
Qwen3.8-27B – вижте повече и го изтеглете от тук
Това вече не е модел, предназначен само за обикновен чат.
Разработчиците го насочват към програмиране, професионална работа, изследвания, многостъпкови задачи и AI агенти, които могат да използват различни инструменти.
Особено важно за бизнеса е, че моделът може да бъде свален и изпълняван локално. В Hugging Face вече има множество квантизирани версии, предназначени за системи като llama.cpp, Ollama и LM Studio.
Това не означава, че пълният модел ще работи комфортно на всеки евтин лаптоп. Скоростта, дължината на контекста и възможностите зависят от RAM, видеопаметта, квантизацията и използвания софтуер.
Но вече говорим за клас AI, който може да бъде използван на мощна персонална работна станция, вместо да изисква център за данни.
И качеството също е показателно.
В публикуваните от Qwen оценки Qwen3.8-27B достига 61,7 точки на SWE-bench Pro, 89,2 на GPQA Diamond и 90,3 на LiveCodeBench v6. На някои от тези тестове моделът е конкурентен дори на много по-големи затворени системи.
Потребители го сравняват с Claude Opus 4.6
Разбира се, benchmark резултатите не означават, че един модел е „по-добър във всичко“. Част от тестовете са извършени от самия разработчик, условията между различните оценки могат да се различават и реалното представяне зависи от конкретната задача.
Но те показват колко много се е свила разликата между малките локално използваеми модели и най-силните AI системи.
Kimi K3 показва другата крайност
Ако Qwen3.8-27B показва колко мощен AI може да се побере в сравнително малка система, Kimi K3 показва докъде е стигнал другият край на отворените модели.
Moonshot AI публикува през юли 2026 г. теглата на Kimi K3 и техническия доклад за модела.
Kimi K3 – официално GitHub хранилище
Тук мащабът вече е съвсем различен.
Kimi K3 има 2,8 трилиона параметъра.
Това е модел от типа Mixture of Experts — вместо при всяка задача да използва всички 2,8 трилиона параметъра, при обработката на даден token са активни около 104 млрд. параметъра. Моделът разполага с 896 експерта, от които се избират 16, и поддържа контекст от около 1 милион token.
Той има вградени визуални способности и е предназначен не само за разговор, а за продължителна работа по програмиране, анализи, работа с документи и AI агенти.
И най-интересната част е:
теглата на този модел могат да бъдат изтеглени.
Moonshot изрично посочва, че Kimi K3 може да се използва за вътрешни разработки и да бъде внедряван в продукти при условията на лиценза Kimi K3.
Тук е важно терминологично уточнение. Qwen3.8-27B е публикуван под Apache 2.0, докато Kimi K3 има собствен лиценз. Затова най-точно е да говорим за модели с отворени тегла (open-weight models), а не автоматично да приемаме, че всеки от тях е „open source“ в абсолютно еднакъв смисъл.
Kimi K3 няма да работи нормално на обикновен лаптоп
При подобни новини лесно може да се създаде грешно впечатление, че след като моделът може да бъде изтеглен, той може да бъде стартиран на всеки компютър.
Kimi K3 е огромен модел. Теглата му са в MXFP4 формат, а официалният проект препоръчва специализирани системи като vLLM, SGLang и TokenSpeed за внедряването му.
Това е по-скоро сървърна или клъстерна инфраструктура, отколкото модел за стандартен персонален компютър.
Но икономическият въпрос е друг.
Ако една компания реши да използва Kimi K3 в собствена инфраструктура, тя трябва да инвестира в сървъри, видеокарти, електроенергия и специалисти.
Не трябва обаче сама да финансира създаването на 2,8-трилионния модел.
Тази част вече е направена.
От десетки милиони за модела към няколко хиляди за неговото използване
Точно това променя икономиката на AI.
Преди няколко години въпросът за една компания можеше да звучи така:
„Можем ли да си позволим да разработим собствен мощен AI модел?“
За почти всички малки и средни компании отговорът беше очевиден — не.
Днес по-практичният въпрос е:
„Кой готов модел е подходящ за нашата работа и каква инфраструктура ни трябва, за да го използваме?“
Това вече е съвсем различна задача.
За определени приложения един бизнес може да започне с една мощна работна станция и модел като Qwen3.8-27B.
При по-голямо натоварване могат да бъдат използвани един или няколко GPU сървъра.
А огромни модели като Kimi K3 могат да бъдат разполагани в специализирана инфраструктура или използвани през доставчик, без компанията да трябва да ги създава от нулата.
Истинската инвестиция вече може да бъде в бизнеса, а не в самия модел
Това може би е най-важният извод.
За повечето компании няма особена бизнес логика да се опитват да създадат следващия GPT.
Много по-ценно е да вземат вече съществуващ мощен модел и да инвестират в това той да разбира техния бизнес.
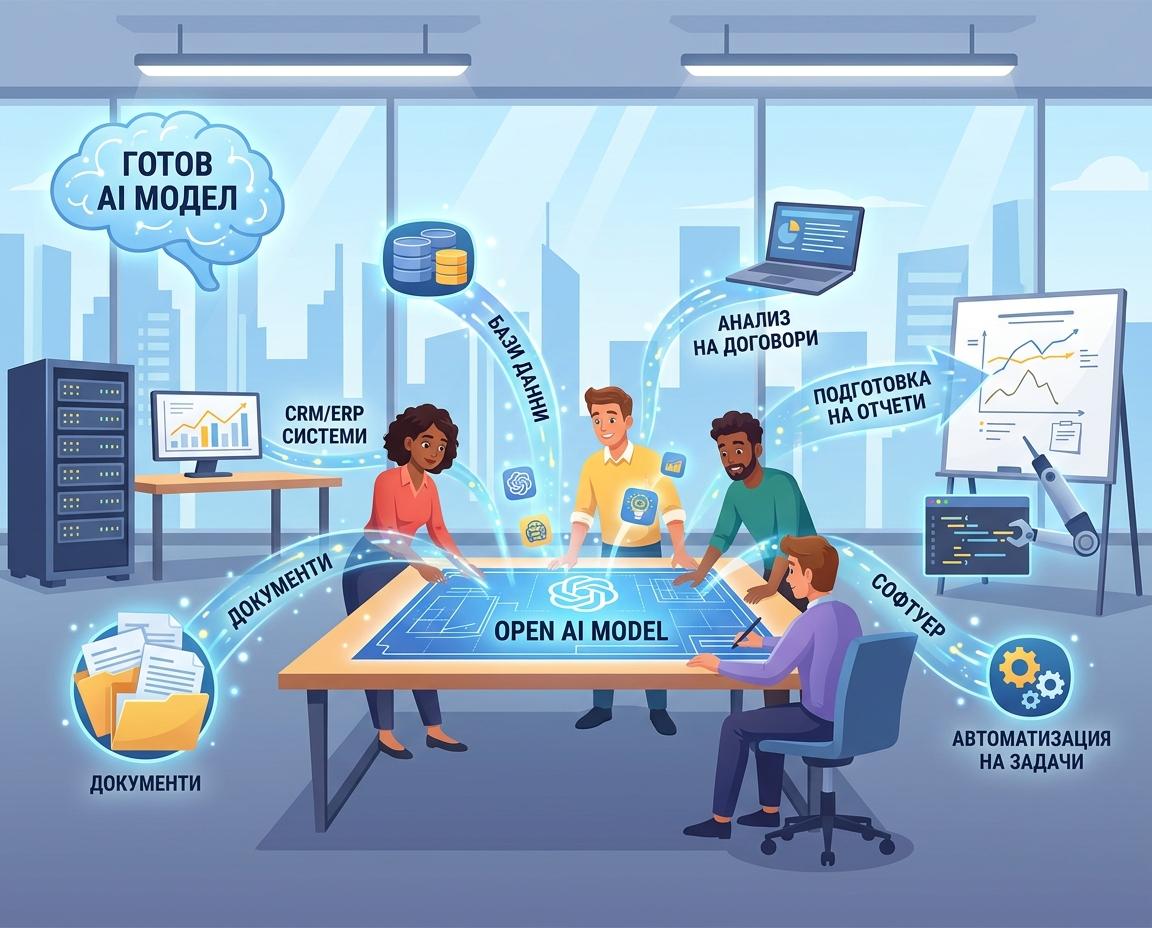
Това означава да бъде свързан с фирмените документи и бази данни, да използва RAG системи за търсене в собственото знание на организацията, да има достъп до вътрешни инструменти и API, да изпълнява автоматизирани процеси и да работи като специализиран AI агент.
Такъв модел може например да анализира хиляди документи, да създава отчети, да помага при програмиране, да обработва вътрешна документация, да търси в големи архиви, да подготвя предложения, да извлича структурирана информация или да управлява други софтуерни инструменти.
При локално изпълнение организацията може и да запази значително по-голям контрол върху това къде се обработват нейните данни.
Разбира се, локалният AI не е безплатен. Има цена за хардуер, електроенергия, поддръжка, специалисти и интеграция. При някои натоварвания облачният API дори може да бъде по-икономичният вариант.
Но мащабът на първоначалната бариера е напълно различен.
На практика модели като Qwen3.8-27B и Kimi K3 могат да се превърнат в собствена AI инфраструктура за бизнеса и научните организации. Една компания например може да свърже модела с вътрешната си документация, CRM, счетоводни и ERP системи и да изгради агенти, които анализират договори и оферти, обработват хиляди документи, подготвят отчети, пишат и проверяват софтуер или автоматизират повтарящи се административни процеси.
Научен институт или университет може да ги използва за търсене и анализ в собствен архив от публикации, извличане на информация от хиляди PDF файлове, работа с експериментални данни, програмиране, подготовка на литературни обзори или изграждане на специализиран асистент, който познава конкретна научна област.
Qwen3.8-27B е особено интересен за подобни локални приложения, защото може да бъде използван на сравнително достъпна собствена хардуерна инфраструктура, докато Kimi K3 е подходящ за много по-мащабни сървърни внедрявания и сложни агентни задачи.
Основното им предимство спрямо услуги като ChatGPT и Claude е не непременно, че винаги са по-интелигентни, а че организацията може да контролира целия модел и начина, по който той работи: да го държи в собствената си инфраструктура, да го адаптира към собствени данни, да го дообучава, да работи офлайн, да не зависи от цена за всеки използван token и да не е обвързана изцяло с правилата и промените на един външен доставчик. При постоянно и голямо натоварване това може да даде и значително по-предвидима цена.
ChatGPT и Claude обаче имат друго голямо предимство — получаваш готова управлявана услуга, най-новите модели, инструменти и инфраструктура, без сам да поддържаш GPU сървъри и софтуер. Освен това бизнес версиите на OpenAI и Anthropic също предлагат сериозни защити на фирмените данни и по подразбиране не използват бизнес съдържанието за обучение на моделите. Затова изборът не е просто „отворен модел срещу ChatGPT или Claude“, а дали организацията иска да наема AI като услуга, или да започне да притежава и управлява собствена AI инфраструктура.
От „можем ли да си позволим AI?“ към „как да го използваме?“
Преди три години най-мощният AI беше технология, чието създаване беше по силите на шепа компании с огромен капитал.
През 2026 г. вече имаме 27-милиардни модели, които могат да бъдат използвани локално, и 2,8-трилионни модели, чиито тегла могат свободно да бъдат изтеглени и внедрявани при условията на съответния лиценз.
Това не означава, че изграждането на AI инфраструктура е станало безплатно.
Означава нещо по-важно:
компаниите вече не трябва непременно да инвестират милиони в създаването на самата интелигентност. Те могат да инвестират в това как тази интелигентност да работи за тях.
И вероятно точно тук е една от най-големите бизнес възможности на следващите години.
Източници и допълнително четене
Stanford Institute for Human-Centered AI — AI Index 2024, Research and Development. Оценки на разходите за изчислителен ресурс при обучението на GPT-4, Gemini Ultra и други големи модели.
Stanford AI Index 2024
Epoch AI — Most of OpenAI’s 2024 compute went to experiments. Анализ на изчислителните разходи на OpenAI и разликата между финално обучение и по-широка R&D дейност.
Epoch AI analysis
Qwen — Qwen3.8-27B. Официалната страница на модела, теглата, техническите характеристики, benchmark резултатите и наличните квантизации.
Qwen3.8-27B в Hugging Face
Moonshot AI — Kimi K3 Open Day. Официалното съобщение за публикуването на теглата, техническия доклад и инфраструктурните компоненти на Kimi K3.
Kimi K3 Open Day
Moonshot AI — Kimi K3 GitHub repository. Архитектура, 2,8 трилиона общи и 104 млрд. активни параметъра, 1M контекст, benchmark резултати, deployment и лиценз.
MoonshotAI/Kimi-K3 в GitHub
Artificial Analysis — Kimi K3 agentic knowledge benchmark. Независима оценка на Kimi K3 при сложни задачи, свързани с работа с документи и AI агенти.
Artificial Analysis – Kimi K3

